作者: 引线小白-本文永久链接:https://www.limoncc.com/post/027d78612e329155/
知识共享许可协议: 本博客采用署名-非商业-禁止演绎4.0国际许可证
一、导言
《Attention is All You Need》发表以来,围绕它的优化就一直不断。其中位置编码就是其中一个重要的问题。其中研究人员苏建林做了很多工作,向其致敬。本文试图系统梳理,做一个总结和评述,并结合一些新架构谈谈长度外推问题。
1.1. 引理1
若 $\bm{x},\bm{y}$是二维实向量,则有 $<\bm{x},\bm{y}>=\mathbb{R}[\bm{x}\bar{\bm{y}}]$。也就是说:两个二维向量的内积,等于把它们当复数看时,一个复数与另一个复数的共轭的乘积实部。
证明是简单
$$\begin{align}
<\bm{x},\bm{y}>
=\bm{y}^H\bm{x}
=\bar{\bm{y}}^\T\bm{x}
=\overline{\bm{y}^\T\bar{\bm{x}}}
=\overline{\bar{\bm{x}}^\T\bm{y}}
=\overline{<\bm{y},\bm{x}>}
=\bm{x}^H\bm{y}
\end{align}$$
补充说明:
欢迎来到线性代数与复数交织的领域!在矩阵和向量运算中,上标 $H$ 代表的是 Hermitian(埃尔米特),它的意思是“共轭转置”(Conjugate Transpose)。有时候你也可能会看到上标 $$ (如 $\bm{x}^$),在大多数线性代数和信号处理教材中,$\bm{x}^H$ 和 $\bm{x}^*$ 是完全一样的意思。
1.1.1. $\bm{x}^H$ 具体怎么算?
它的计算分为两步:先取共轭,再转置。
假设有一个复数列向量 $\bm{x}$:
$$ \bm{x} = \begin{pmatrix} a + bi \ c + di \end{pmatrix} $$
- 第一步:取共轭(实部不变,虚部取反,即把 $i$ 变成 $-i$):
$$ \bar{\bm{x}} = \begin{pmatrix} a - bi \ c - di \end{pmatrix} $$ - 第二步:转置(列向量变行向量):
$$ \bm{x}^H = (\bar{\bm{x}})^\T = \begin{pmatrix} a - bi & c - di \end{pmatrix} $$
特别提醒(结合你的引理):
你的引理1中特别写了“若 $\bm{x},\bm{y}$是二维实向量”。对于实向量而言,它们的元素没有虚部(虚部为0),所以取共轭等于没取。因此,对于实向量,$\bm{x}^H = \bm{x}^\T$。
1.1.2. 为什么内积要用 $H$(共轭转置)来定义?
在复数域中,向量的内积标准定义是 $\langle \bm{x}, \bm{y} \rangle = \bm{y}^H \bm{x}$,而不是 $\bm{y}^\T \bm{x}$。
为什么要多此一举取共轭呢?这是为了保证向量与自身的内积(即向量长度的平方)是一个实数,且非负。
- 如果用转置 $\bm{x}^\T \bm{x}$:
假设 $\bm{x} = \begin{pmatrix} 1 \ i \end{pmatrix}$,那么 $\bm{x}^\T \bm{x} = 1 \times 1 + i \times i = 1 - 1 = 0$。长度为0?这不合理。 - 如果用共轭转置 $\bm{x}^H \bm{x}$:
$\bm{x}^H \bm{x} = \overline{1} \times 1 + \overline{i} \times i = 1 \times 1 + (-i) \times i = 1 + 1 = 2$。长度的平方是2,这是正确的。
1.1.3. 逐行解释证明过程
给出的证明过程,其实是在推导复内积的对称性(即 $\langle \bm{x}, \bm{y} \rangle = \overline{\langle \bm{y}, \bm{x} \rangle}$)。加上详细的注释:
$$ \begin{align}
\langle \bm{x}, \bm{y} \rangle
&= \bm{y}^H \bm{x} \quad \scriptsize \text{(这是复向量内积的标准定义)} \\
&= \bar{\bm{y}}^\T \bm{x} \quad \scriptsize\text{(共轭转置 } H \text{ 的定义:先共轭,后转置,即 } \bm{y}^H = \bar{\bm{y}}^\T \text{)} \\
&= \overline{\bm{y}^\T \bar{\bm{x}}} \quad \scriptsize\text{(矩阵乘法的性质:共轭可以提出来,即 } \bar{A}B = \overline{A \bar{B}} \text{)} \\
&= \overline{\bar{\bm{x}}^\T \bm{y}} \quad \scriptsize\text{(因为内积结果是标量,标量的转置等于自身,所以 } \bm{y}^\T \bar{\bm{x}} = (\bm{y}^\T \bar{\bm{x}})^\T = \bar{\bm{x}}^\T \bm{y} \text{)} \\
&= \overline{\langle \bm{y}, \bm{x} \rangle} \quad \scriptsize\text{(根据内积定义, } \langle \bm{y}, \bm{x} \rangle = \bm{x}^H \bm{y} = \bar{\bm{x}}^\T \bm{y} \text{,代入上面即可)} \\
&= \bm{x}^H \bm{y} \quad \scriptsize\text{(根据第一步, } \overline{\langle \bm{y}, \bm{x} \rangle} \text{ 展开后,共轭的共轭抵消,实质上等于 } \bm{x}^H \bm{y} \text{)}
\end{align} $$
1.1.4. 关于引理1本身的补充
引理1的核心思想(两个二维实向量的内积,等于把它们当复数看时乘积的实部)其实非常直观。我们可以直接用代数验证:
设 $\bm{x} = \begin{pmatrix} a \ b \end{pmatrix}$,$\bm{y} = \begin{pmatrix} c \ d \end{pmatrix}$。
- 作为向量的内积:$\langle \bm{x}, \bm{y} \rangle = ac + bd$。
- 作为复数的乘积:把 $\bm{x}$ 看作复数 $z_1 = a + bi$,把 $\bm{y}$
看作复数 $z_2 = c + di$。
$$ z_1 \bar{z_2} = (a+bi)\overline{(c+di)} = (a+bi)(c-di) = (ac+bd) + (bc-ad)i $$
取它的实部 $\mathbb{R}[z_1 \bar{z_2}] = ac + bd$。
两者完全相等!这就是引理1要表达的本质,而 $H$ 只是帮我们在矩阵语言下严谨地表达这个“取共轭再相乘”的过程。
二、加性位置编码
2.1、理论分析
《Attention is All You Need》提出了正弦位置编码(Sinusoidal Positional Encoding)[^1]。目前典型理论解释是打破注意力机制的对称性,实现非对称性、远程衰减、平移不变。
我们来做一个简单回顾:
$$\begin{align}
\mathrm{Attention}(\bm{Q},\bm{K},\bm{V}) = \mathrm{softmax}\bigg[\frac{1}{\sqrt{d}}\bm{Q}\bm{K}^\T\bigg]\bm{V}
\end{align}$$
其中 $\displaystyle d=\dim[\bm{Q}][2]$ 即 $d$是查询矩阵的特征维度。我们暂且忽略放缩操作 $ d$,单独考察其中任意两个位置token的注意力权重,注意向量默认是列向量,与数学习惯保持一致,写pytorch代码只需考虑一个转置即可。
$$\begin{align}
a_{mn} = \exp\big[\bm{q}_{m}^\T\bm{k}_n\big]/\sum_{n}\exp\big[\bm{q}_{m}^\T\bm{k}_n\big]
=\frac{\mathrm{e}^{\bm{q}_{m}^\T\bm{k}_n}}{\sum_{n}\mathrm{e}^{\bm{q}_{m}^\T\bm{k}_n}}
=\mathrm{softmax}\big[\bm{q}_m^\T\bm{K}^\T\big][n]
\end{align}$$
这样对于一个有 $n$个token, $d$个特征的输入 $\displaystyle \bm{X}_{n\times d}=[\bm{x}_1,\bm{x}_2,\cdots,\bm{x}_n]^\T$ 语言模型而言其实有:
$$\begin{align}
a_{mn} = \mathrm{softmax}\big[\bm{x}_m^\T\bm{X}^\T\big][n] = \mathrm{softmax}\big[\bm{x}_n^\T\bm{X}^\T\big][m]=a_{nm}
\end{align}$$这样注意力分数的计算其实具有对称性、平移不变,远程等同的性质。这里在啰嗦一下输入 $\bm{X}$有 $n$行,代表有 $n$个词。也就是说 $\bm{X}$的每一行代表一个词。每个词有$d$个特征,是个行向量。有:
$a_{mn}=a_{nm}$ 表示轮换对称,即「我爱=爱我」
$a_{mn}= a_{m,(n+\Delta t)}$表示非衰减,即「我爱=我……爱」
$a_{mn}= a_{(m+\Delta t),(n+\Delta t)}$表示平移不变,即「我爱=……我爱」
我们继续,为了打破这种对称性同时实现衰减以及保留一定的平移不变形,令 $\displaystyle f(\bm{x}_m,\bm{x}_n)=a_{mn}$,我们希望引入位置信息,使得注意力分数满足下述性质:非对称性、远程衰减、平移不变。
$$\begin{align}
\left\{
\begin{aligned}
&\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_n)
\neq \tilde{f}(\bm{y}_m+\bm{p}_m,\bm{x}_n+\bm{p}_n)\\
&\displaystyle \lim_{\Delta t\to\infty} \tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_{n+\Delta t}+\bm{p}_{n+\Delta t}) \downarrow a \\
&\tilde{f}(\bm{x}_{m+\Delta t}+\bm{p}_{m+\Delta t},\bm{y}_{n+\Delta t}+\bm{p}_{n+\Delta t}) = \tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_n)
\end{aligned}
\right.
\end{align}$$
2.1.1、非对称性
为了便于分析,我们对两边在点 $(\bm{x}_m,\bm{y}_n)$出进行泰勒展开到二阶微分
$$\begin{align}
\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_n)
&\approx f(\bm{x}_m,\bm{y}_n)
+\bm{p}_m^\T \frac{\partial f}{\partial \bm{x}_m}
+\bm{p}_n^\T \frac{\partial f}{\partial \bm{y}_n}
+\frac{1}{2}\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{x}_m^2}\bm{p}_m
+\frac{1}{2}\bm{p}_n^\T \frac{\partial^2 f}{\partial \bm{y}_n^2}\bm{p}_n
+\underbrace{\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}\bm{p}_n}_{\bm{p}_m^\T \bm{H} \bm{p}_n}\\
\tilde{f}(\bm{y}_m+\bm{p}_m,\bm{x}_n+\bm{p}_n)
&\approx f(\bm{y}_m,\bm{x}_n)
+\bm{p}_m^\T \frac{\partial f}{\partial \bm{y}_m}
+\bm{p}_n^\T \frac{\partial f}{\partial \bm{x}_n}
+\frac{1}{2}\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{y}_m^2}\bm{p}_m
+\frac{1}{2}\bm{p}_n^\T \frac{\partial^2 f}{\partial \bm{x}_n^2}\bm{p}_n
+\underbrace{\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}\bm{p}_n}_{\bm{p}_m^\T \bm{H} \bm{p}_n}\\
\end{align}$$
可以看到第二项到第三项是关于位置的绝对信息。第六项,特别的记为 $ \bm{p}_m^\T \bm{H} \bm{p}_n$是关于位置的相对信息。显然第二项到第三项是关于位置的绝对信息打破了轮换对称。
2.1.2、远程衰减
要实现衰减,考察 $\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_{n+\Delta t})$
$$\begin{align}
&\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_{n+\Delta t}+\bm{p}_{n+\Delta t}) \\
&\approx f(\bm{x}_m,\bm{y}_n)
+\bm{p}_m^\T \frac{\partial f}{\partial \bm{x}_m}
+\bm{p}_{n+\Delta t}^\T \frac{\partial f}{\partial \bm{y}_n}
+\frac{1}{2}\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{x}_m^2}\bm{p}_m
+\frac{1}{2}\bm{p}_{n+\Delta t}^\T \frac{\partial^2 f}{\partial \bm{y}_n^2}\bm{p}_{n+\Delta t}
+\bm{p}_m^\T \frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}\bm{p}_{n+\Delta t}
\end{align}$$
与 $\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_n)$ 比较,我们暂且认为 $\displaystyle \frac{\partial^2 f}{\partial \bm{x}_m^2}、\frac{\partial^2 f}{\partial \bm{y}_n^2}、\frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}$ 是对称矩阵。这样显然 $\bm{p}_n\mid\bm{p}_n\mid$ 应该是关于位置 $n$的减函数,而且内积 $<\bm{p}_{m},\bm{p}_n>$ 也应该是关于相对位置 $n-m$ 的减函数
2.1.3、平移不变
要实现平移不变,考察 $\tilde{f}(\bm{x}_{m+\Delta t}+\bm{p}_{m+\Delta t},\bm{y}_n+\bm{p}_{n+\Delta t})$
$$\begin{align}
&\tilde{f}(\bm{x}_{m+\Delta t}+\bm{p}_{m+\Delta t},\bm{y}_{n+\Delta t}+\bm{p}_{n+\Delta t}) \\
&\approx f(\bm{x}_m,\bm{y}_n)
+\bm{p}_{m+\Delta t}^\T \frac{\partial f}{\partial \bm{x}_m}
+\bm{p}_{n+\Delta t}^\T \frac{\partial f}{\partial \bm{y}_n}
+\frac{1}{2}\bm{p}_{m+\Delta t}^\T \frac{\partial^2 f}{\partial \bm{x}_m^2}\bm{p}_{m+\Delta t}
+\frac{1}{2}\bm{p}_{n+\Delta t}^\T \frac{\partial^2 f}{\partial \bm{y}_n^2}\bm{p}_{n+\Delta t}
+\bm{p}_{m+\Delta t}^\T \frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}\bm{p}_{n+\Delta t}
\end{align}$$
与 $\tilde{f}(\bm{x}_m+\bm{p}_m,\bm{y}_n+\bm{p}_n)$比较,我们暂且认为 $\displaystyle \frac{\partial^2 f}{\partial \bm{x}_m^2}、\frac{\partial^2 f}{\partial \bm{y}_n^2}、\frac{\partial^2 f}{\partial \bm{x}_m \partial \bm{y}_n}$ 是对称矩阵。由于一阶项的存在,要可能保留平移不变形必然要求 $ |\bm{p}_n|、<\bm{p}_{m},\bm{p}_n>$ 应该与绝对位置无关,而只与绝对位置相关。也就是要求内积应该形如如下函数
$$\begin{align}
<\bm{p}_{m},\bm{p}_n> = g(m-n) = g(n-m)
\end{align}$$
2.2、正弦位置编码
为了简化分析我们暂时只考虑两个特征维度 $\dim[\bm{p}_m]=2$。我们有 $ \bm{p}_m=[x_m,y_m]^\T,\bm{p}_n=[x_n,y_n]^\T$。当做复数看待,就有
$$\begin{align}
\left\{\begin{aligned}
&p_m = x_m + \mathrm{i}y_m=R_m \mathrm{e}^{\mathrm{i}\varPsi_m}\\
&p_n = x_n + \mathrm{i}y_n=R_n \mathrm{e}^{\mathrm{i}\varPsi_n}\\
&q(n-m) = S_{n-m}\mathrm{e}^{\mathrm{i}\varPhi_{n-m}}
\end{aligned}
\right.
\end{align}$$
其中 $q(n-m)$的实部 $\mathbb{R}[q(n-m)] = g(n-m)$。根据引理1我们有
$$\begin{align}
<p_m,p_n> = \mathcal{R}[p_m\overline{p}_n] = \mathcal{R}[q(m-n)]=g(m-n)
\end{align}$$进一步有
$$\begin{align}
R_m \mathrm{e}^{\mathrm{i}\varPsi_m}
R_n \mathrm{e}^{-\mathrm{i}\varPsi_n}
=S_{n-m}\mathrm{e}^{\mathrm{i}\varPhi_{m-n}}
\Leftrightarrow
\left\{\begin{aligned}
&R_mR_n = S_{n-m}\\
&\varPsi_m-\varPsi_n = \varPhi_{m-n}
\end{aligned}
\right.
\end{align}$$
对于方程第一项令 $n=m$有 $R_m^2 = S_0\Rightarrow R_m = C = \sqrt{S_0}$,也就是说$R_m$是一个常数,不妨令$R_m=1$;对于方程的第二项令 $n=0\Rightarrow \varPsi_m-\varPsi_0 = \varPhi_{m}$,简单起见设 $\varPsi_0=0$,那么 $\varPsi_m=\varPhi_{m} $,这时令 $n=m-1$有 $ \varPsi_m-\varPsi_{m-1}=\varPhi_{1}=\theta $。这样等差数列$\{\varPsi_m\}$
$$\begin{align}
\{\varPsi_m\mid \varPsi_m=m\theta\}
\end{align}$$
于是我们就有了所谓的正弦位置编码
$$\begin{align}
p_m = \mathrm{e}^{\mathrm{i}m\theta} \Leftrightarrow \bm{p}_m = [\cos(m\theta),\sin{m\theta}]^\T
\end{align}$$
这样更高维的偶数维位置编码,我们可以表示为多个二维位置编码的组合:
$$\begin{align}
\bm{p}_m = \begin{bmatrix}
\mathrm{e}^{\mathrm{i}m\theta_0} \
\mathrm{e}^{\mathrm{i}m\theta_1}\\
\vdots\\
\mathrm{e}^{\mathrm{i}m\theta_{d/2-1}}
\end{bmatrix}
\Leftrightarrow
\bm{p}_m = \begin{bmatrix}
\cos(m\theta_0)\\\sin{m\theta_0}\\
\cos(m\theta_1)\\\sin{m\theta_1}\\
\vdots\\
\cos(m\theta_{d/2-1})\\\sin{m\theta_{d/2-1}}\\
\end{bmatrix}
\end{align}$$
显然它满足(14)式。当然这是只是一个简单解。截止目前为止,为了修正注意力权重对位置不敏感的缺陷,通过引入加法位置编码,先后解决非对称、平移不变问题,下面来考察一下衰减问题:
首先与 $\bm{p}_m、|\bm{p}_m|$相关的一阶、二阶项随 $m$的变换是不确定的。这个时候只能希望寄托在内积上,在二阶意义下实现衰减。我们来考察一番:
$$\begin{align}
<\bm{p}_m,\bm{p}_n>
&=\mathcal{R}\big[\mathrm{e}^{\mathrm{i}(m-n)\theta_0}
+\mathrm{e}^{\mathrm{i}(m-n)\theta_1}
+\cdots
+\mathrm{e}^{\mathrm{i}(m-n)\theta_{d/2-1}}
\big]\\
&=\mathcal{R}\bigg[\sum_{i=0}^{d/2-1}\mathrm{e}^{\mathrm{i}(m-n)\theta_i}\bigg]\\
&=\frac{d}{2}\mathcal{R}\bigg[\sum_{t=0}^{1-d/2}\mathrm{e}^{\mathrm{i}(m-n)\theta(td/2)}\frac{1}{d/2}\bigg]\Leftarrow t=\frac{i}{d/2}\\
&\approx\frac{d}{2}\mathcal{R}\bigg[\sum_{t=0}^{1}\mathrm{e}^{\mathrm{i}(m-n)\theta(td/2)}\frac{1}{d/2}\bigg]
\Leftarrow\frac{d}{2}\mathcal{R}\bigg[\sum_{0}^{1}f(t)\Delta t\bigg]
\Leftarrow \Delta t = t+1-t=\frac{d}{2}
\\
&\approx\frac{d}{2}\mathcal{R}\bigg[\int_{t=0}^{1}\mathrm{e}^{\mathrm{i}(m-n)\theta(td/2)}dt\bigg]\\
&=\frac{d}{2}\mathcal{R}\bigg[\int_{0}^{1}\mathrm{e}^{\mathrm{i}(m-n)\theta_t}dt\bigg]\\
\end{align}$$
这样只要选择恰当的 $\theta(i)$就能使得
$$\begin{align}
\exists \theta(i) \to \lim_{m-n\to \infty}<\bm{p}_m,\bm{p}_n>
\approx\lim_{m-n\to \infty}\frac{d}{2}\mathcal{R}\bigg[\int_{0}^{1}\mathrm{e}^{\mathrm{i}(m-n)\theta(td/2)}\frac{1}dt\bigg] \downarrow a
\end{align}$$
《Attention is All You Need》论文选择的是 $\theta_i = 10000^{-2i/d}\Leftrightarrow \theta_t=10000^{-t}$。其实我们也可以选择其他函数形式
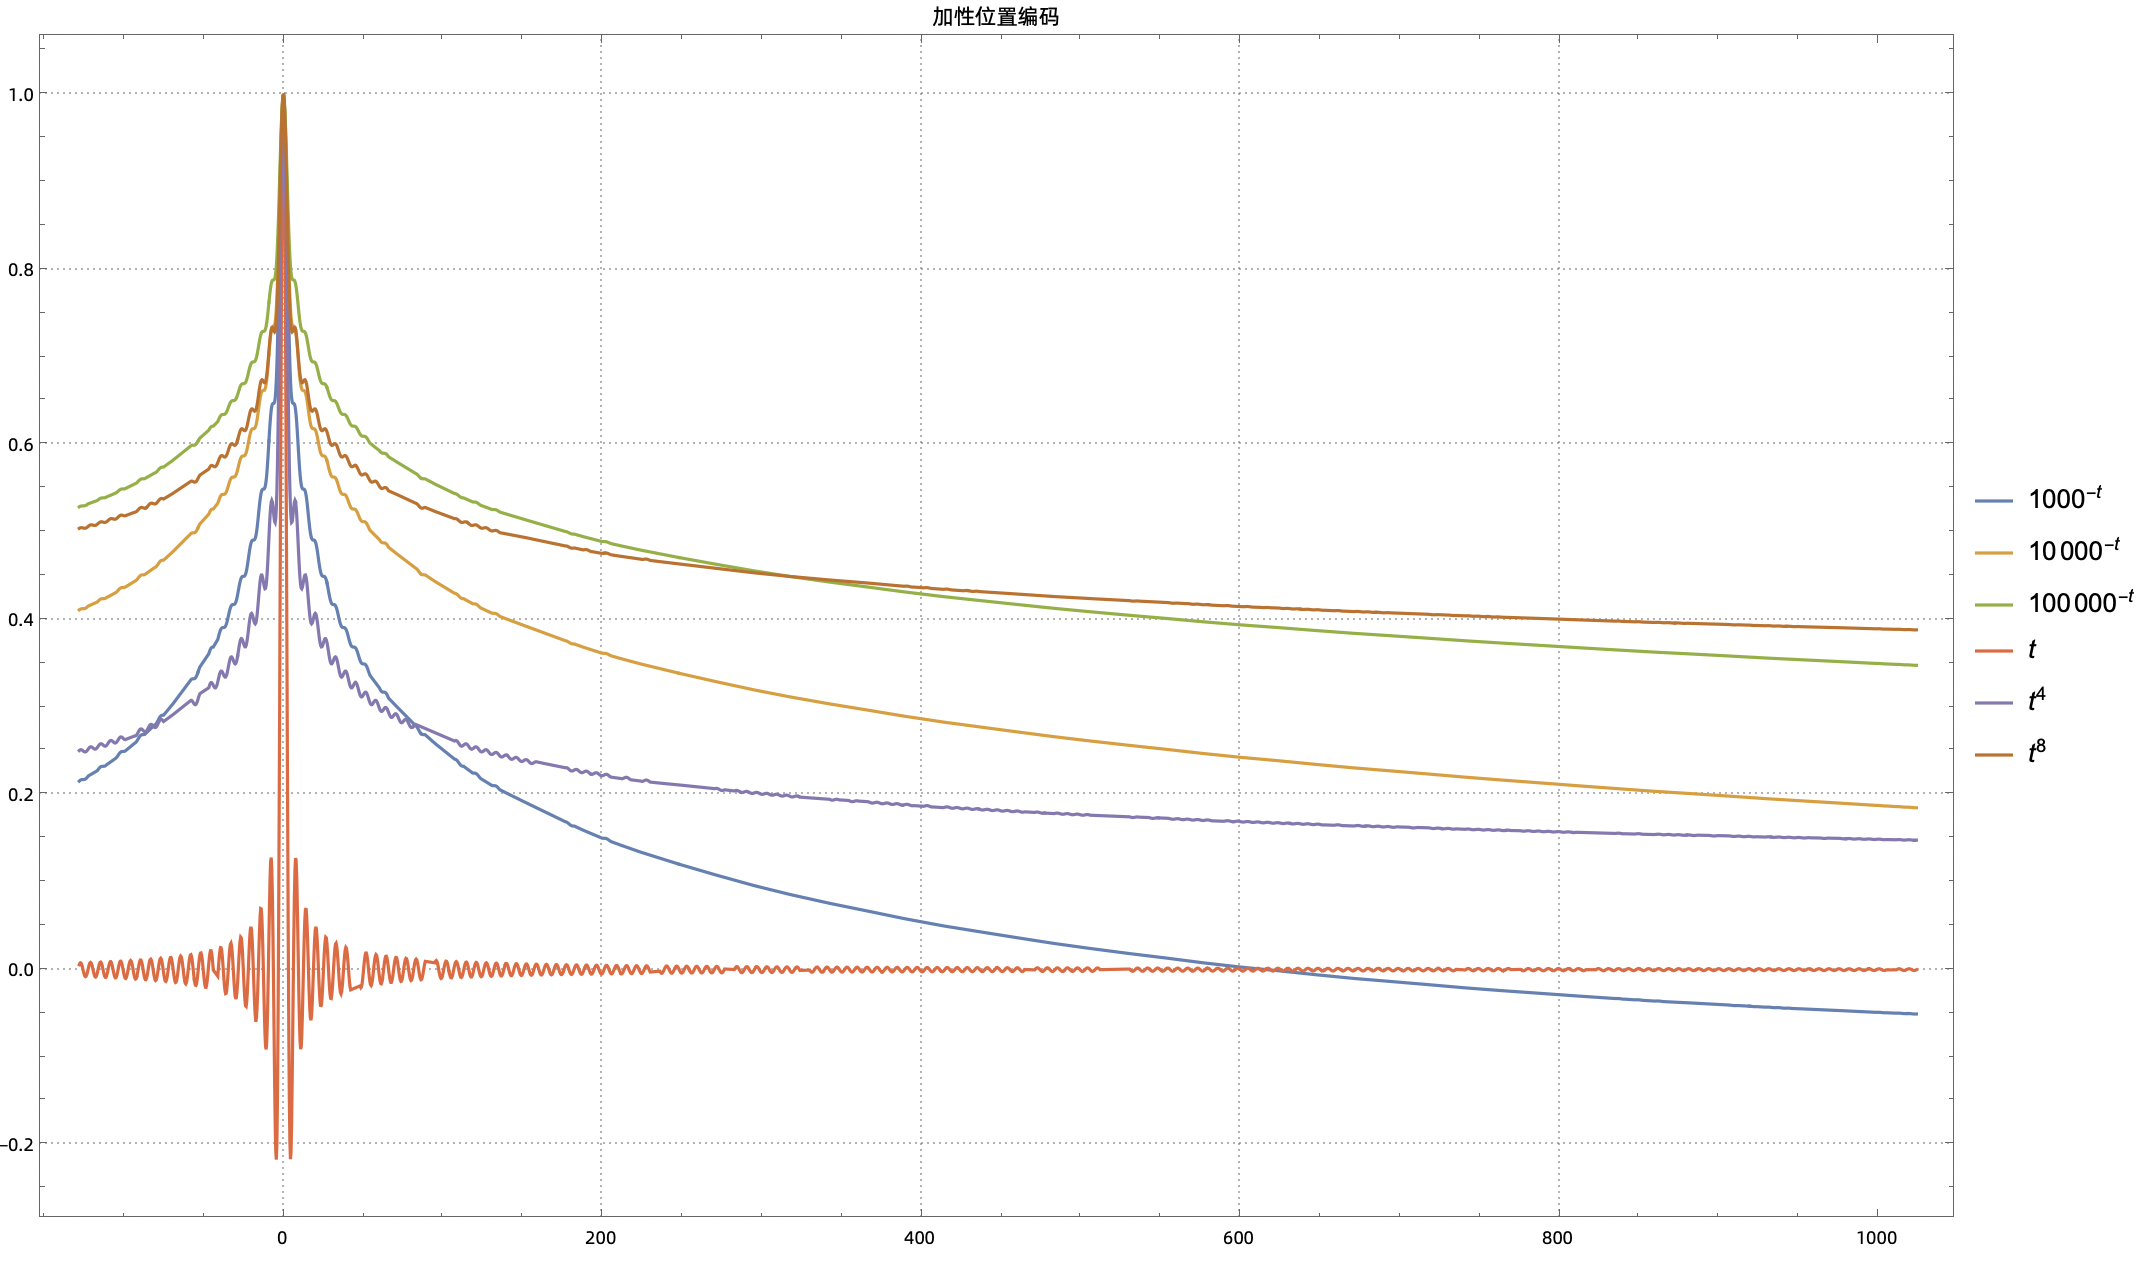
个人认为其实没啥区别。别忘了,到目前为止,我们的推导都是基于 $\bm{H}=\bm{E}$这个单位矩阵简单情况,对于一般的 $\bm{H}$,使用上述正弦位置编码,还具备以上性质吗?答案是否定的,考虑一下对角矩阵情况
$$\begin{align}
\bm{p}_m^\T\bm{H}\bm{p}_n
&=\bm{p}_m^\T \mathrm{diag}[H_{i,i}]\bm{p}_n
=\sum_{i=0}^{d/2-1}H_{2i,2i}\cos{m\theta_i}\cos{n\theta_i}+H_{2i+1,2i+1}\sin{m\theta_i}\sin{n\theta_i}\\
&=\frac{1}{2}\sum_{i=0}^{d/2-1}(H_{2i,2i}+H_{2i+1,2i+2})\cos[(m-n)\theta_i]+\frac{1}{2}\sum_{i=0}^{d/2-1}(H_{2i,2i}-H_{2i+1,2i+2})\cos[(m+n)\theta_i]\\
&=\frac{1}{2}\sum_{i=0}^{d/2-1}(H_{2i,2i}+H_{2i+1,2i+2})\cos[(m-n)\theta_i] \Leftarrow \text{let } \\
&=\frac{1}{2}\sum_{i=0}^{d/2-1}C_i\cos[(m-n)\theta_i] \Leftarrow \text{let } H_{2i,2i}+H_{2i+1,2i+2} = C_i\\
&\approx \frac{d}{2}\mathcal{R}\bigg[\int_{0}^{1}C_{td/2}\mathrm{e}^{\mathrm{i}(m-n)\theta_t}dt\bigg]\\
\end{align}$$
在施加 $ H_{2i,2i}-H_{2i+1,2i+2} = 0$约束后,可能具备一定衰减性质。
2.3、加性位置编码评述
1、由于注意力计算的对称性和语言的非对称性,必须为注意力机制引入位置信息。 最直接的方式就是为每个token加上位置信息,然后发现要保留语言的非对称性、远程衰减、平移不变这个三个重要性质,必须对编码形式加以约束,而这就是正弦位置编码。
2、在寻找正弦位置编码过程中使用了渐进分析,同时必须注意到一阶项的不可消除、二阶项渐进性质,这就导致了加性位置编码并非完美实现了非对称性、远程衰减和平移不变。尤其是对交互项 $\bm{H}$的约束假设。更表明这种编码的局限性。所以我们看到在Bert模型中,放弃了这种编码而改为直接学习位置编码。
3、直接外生学习位置编码的缺点非常明显,那就是超出长度无法计算。要处理任意长度,还是要回到内生位置编码这条道路上。而乘性位置编码[^2]较好克服了加性位置编码缺点,接下来我们来回顾一下。
三、乘性位置编码
3.1、引入
首先回顾一下注意力分数的计算
$$\begin{align}
a_{mn} = \exp\big[\bm{q}_{m}^\T\bm{k}_n\big]/\sum_{n}\exp\big[\bm{q}_{m}^\T\bm{k}_n\big]
=\mathrm{softmax}\big[\bm{q}_m^\T\bm{K}^\T\big][n]
=\frac{\mathrm{e}^{\bm{q}_{m}^\T\bm{k}_n}}{\sum_{n}\mathrm{e}^{\bm{q}_{m}^\T\bm{k}_n}}
\end{align}$$
这样对于一个有 $n$个token, $d$个特征的输入 $\displaystyle \bm{X}_{n\times d}=[\bm{x}_1,\bm{x}_2,\cdots,\bm{x}_n]^\T$ 语言模型而言其实有:
$$\begin{align}
a_{mn} = \mathrm{softmax}\big[\bm{x}_m^\T\bm{X}^\T\big][n] = \mathrm{softmax}\big[\bm{x}_n^\T\bm{X}^\T\big][m]=a_{nm}
\end{align}$$这样注意力分数的计算其实具有对称性、平移不变,远程等同的性质。实际上这些性质的根源其实是内积 $<\bm{q}_m,\bm{k}_n>$导致的。要改变上述性质就必须对输入$\bm{q}_m,\bm{k}_n$施加影响令$\bm{\tilde{q}}_m = \rho(\bm{q},m)、\bm{\tilde{k}}_n= \rho(\bm{k},n)$,这样内积就变为 $<\bm{\tilde{q}}_m,\bm{\tilde{k}}_n>=<\rho(\bm{q},m),\rho(\bm{k},n)>$。注意这个时候我们没有对 $\rho(\cdot,\cdot)$做任何假设。
3.2、分析
为了简化分析我们暂时只考虑两个特征维度 $\dim[\bm{q}_m]=dim[\bm{k}_n]=2$。当做复数看待,同时根据引理1有:
$$\begin{align}
<\bm{\tilde{q}}_m,\bm{\tilde{k}}_n>
=<\rho(\bm{q},m),\rho(\bm{k},n)>
=\mathbb{R}\big[\rho(\bm{q},m)\overline{ \rho(\bm{k},n)}\big]
=\mathbb{R}\big[g(\bm{q},\bm{k},m-n)\big]
\end{align}$$这里做了一个关键假定,变化后的内积只与原始token和相对位置相关。那么它满足非对称性、远程衰减、平移不变么?,我们来讨论一下:
3.2.1、非对称性
$a_{mn}=\mathrm{softmax}\big[\bm{\tilde{x}}_m^\T\bm{\widetilde{X}}^\T\big][n]\neq \mathrm{softmax}\big[\bm{\tilde{x}}_n^\T\bm{\widetilde{X}}^\T\big][m]=a_{nm}$。虽然 $g(\bm{x},\bm{y},m-n)=g(\bm{y},\bm{x},m-n)$,但是对于其他内积项 $g(\bm{x},\bm{z},m-t_z)\neq g(\bm{x},\bm{z},n-t_z)$,所以是非对称的。
3.2.2、远程衰减和平移不变
这需要求出 $\rho(\cdot,\cdot)$的具体形式,写为复数形式有:
$$\begin{align}
\rho(\bm{q},m)\overline{ \rho(\bm{k},n)}
&=R_\rho(\bm{q},m)\mathrm{e}^{\mathrm{i}\theta_\rho(\bm{q},m)}R_\rho(\bm{k},n)\mathrm{e}^{-\mathrm{i}\theta_\rho(\bm{k},n)}\\
&=R_\rho(\bm{q},m)\cdot R_\rho(\bm{k},n)\cdot\exp\big[\mathrm{i}\theta_\rho(\bm{q},m)-\mathrm{i}\theta_\rho(\bm{k},n)\big]\\
&=R_g(\bm{q},\bm{k},m-n)\exp\big[\mathrm{i}\theta_g(\bm{q},\bm{k},m-n)\big]\\
&=g(\bm{q},\bm{k},m-n)
\end{align}$$
解这个方程组
$$\begin{align}
\left\{ \begin{matrix}
&R_\rho(\bm{q},m)R_\rho(\bm{k},n)
=R_g(\bm{q},\bm{k},m-n)\\
&\theta_\rho(\bm{q},m)-\theta_\rho(\bm{k},n)
=\theta_g(\bm{q},\bm{k},m-n)
\end{matrix}
\right.
\end{align}$$
对于第一个位置的编码,显然设定为 $\rho(\bm{q},0)=\bm{q}$、 $\rho(\bm{k},0)=\bm{k}$是比较方便的。这样有
$$\begin{align}
m=n&\to R_\rho(\bm{q},m)R_\rho(\bm{k},m)
=R_g(\bm{q},\bm{k},0)=R_\rho(\bm{q},0)R_\rho(\bm{k},0)\\
&\to R_\rho(\bm{q},m)R_\rho(\bm{k},m)=||\bm{q}|||\bm{k}||\\
&\to R_\rho(\bm{q},m) = ||\bm{q}||、R_\rho(\bm{k},m) = ||\bm{k}||
\end{align}$$
对于条件$ R_\rho(\bm{q},m)R_\rho(\bm{k},m)=||\bm{q}|||\bm{k}||$, $R_{\rho}$的解比较多,为简单计,最后的设定为不依赖位置 $m$的 形式 $ R_\rho(\bm{x},m)=||\bm{x}||$。
同样有
$$\begin{align}
m=n&\to \theta_\rho(\bm{q},m)-\theta_\rho(\bm{k},m)
=\theta_g(\bm{q},\bm{k},0)=\theta_\rho(\bm{q},0)-\theta_\rho(\bm{k},0)\\
&\to \theta_\rho(\bm{q},m)-\theta_\rho(\bm{k},m)=\theta_\rho(\bm{q})-\theta_\rho(\bm{k})\\
&\to \theta_\rho(\bm{q},m)-\theta_\rho(\bm{q}) = \theta_\rho(\bm{k},m)-\theta_\rho(\bm{k})\\
&\to \varphi(m)=\theta_\rho(\bm{q},m)-\theta_\rho(\bm{q}) = \theta_\rho(\bm{k},m)-\theta_\rho(\bm{k})\\
& \to \theta_\rho(\bm{q},m)=\theta_\rho(\bm{q})+\varphi(m)\\
&\downarrow\\
n=m-1 &\to \varphi(m)-\varphi(m-1)=\theta_\rho(\bm{q},m)-\theta_\rho(\bm{q})-\theta_\rho(\bm{k},m-1)+\theta_\rho(\bm{k})\\
&\to \varphi(m)-\varphi(m-1) = \theta_\rho(\bm{q},m)-\theta_\rho(\bm{k},m-1)+\theta_\rho(\bm{k})–\theta_\rho(\bm{q})\\
&\to \varphi(m)-\varphi(m-1) = \theta_g(\bm{q},\bm{k},1)+\theta_\rho(\bm{k})–\theta_\rho(\bm{q})
\end{align}$$
显然 $ \varphi(m)$是一个等差数列,不妨令 $ \varphi(m)-\varphi(m-1)=\theta$,这样有 $ \varphi(m)=m\theta$,于是有
$$\begin{align}
\theta_\rho(\bm{q},m)=\theta_\rho(\bm{q})+m\theta
\end{align}$$
代入就得到了 $\displaystyle \rho(\bm{q},m)
=||\bm{q}||\mathrm{e}^{\mathrm{i}(\theta_\rho(\bm{q})+m\theta)}
=\bm{q}\mathrm{e}^{\mathrm{i}m\theta}$,这就是我们要的解:
$$\begin{align}
\rho(\bm{q},m)
=\bm{q}\mathrm{e}^{\mathrm{i}m\theta}
\end{align}$$
对于乘性位置编码 $\rho(\bm{q},m) = \bm{q}\,\mathrm{e}^{\mathrm{i}m\theta}$,内积变为
$$
\langle \tilde{\bm{q}}_m, \tilde{\bm{k}}_n \rangle
= \mathbb{R}\big[ \bm{q}\,\overline{\bm{k}}\,\mathrm{e}^{\mathrm{i}(m-n)\theta} \big].
$$
这意味着,内积被一个纯粹的相对相位 $\mathrm{e}^{\mathrm{i}(m-n)\theta}$ 所调制。与加性位置编码不同的是,这里不再出现由绝对位置带来的扰动项——乘性形式天然地把一切绝对位置信息吸收进了同一个旋转因子,从而在不引入额外二阶项干扰的情况下,精确实现了“只依赖相对位置”的目标。因此,平移不变性严格成立;非对称性由 softmax 中所有内积的集合关系保证(虽 $g(\bm{x},\bm{y},m-n)=g(\bm{y},\bm{x},m-n)$,但在整体 attention 分布中 $\bm{x}_m$ 面对不同的 $\bm{y}_n$ 时其相对位置不同,故整体非对称)。
至于远程衰减,我们需要看向量 $\bm{q},\bm{k}$ 经过旋转之后,其内积在 $|m-n|$ 增大时的行为。在二维情形中,$\langle \tilde{\bm{q}}_m, \tilde{\bm{k}}_n \rangle = |\bm{q}||\bm{k}|\cos\big(\theta_{qk} + (m-n)\theta\big)$,它会随着 $|m-n|$ 增大而振荡,并不一定衰减。但当维度 $d$ 增大、并在不同维度对上赋予不同的旋转频率 $\theta_i$ 时,情况就不同了。
推广到多维:设 $\bm{q},\bm{k}\in\mathbb{R}^d$,$d$ 为偶数。将维度两两分组,第 $i$ 组对应一个旋转角频率 $\theta_i$。定义分块对角旋转矩阵
$$
\bm{R}_m =
\begin{pmatrix}
\cos m\theta_0 & -\sin m\theta_0 & & & \\
\sin m\theta_0 & \cos m\theta_0 & & & \\
& & \cos m\theta_1 & -\sin m\theta_1 & \\
& & \sin m\theta_1 & \cos m\theta_1 & \\
& & & \ddots & \\
& & & & \cos m\theta_{d/2-1} & -\sin m\theta_{d/2-1} \\
& & & & \sin m\theta_{d/2-1} & \cos m\theta_{d/2-1}
\end{pmatrix}.
$$
则有 $\tilde{\bm{q}}_m = \bm{R}_m\bm{q}$,$\tilde{\bm{k}}_n = \bm{R}_n\bm{k}$,且由于旋转矩阵满足 $\bm{R}_m^\top = \bm{R}_{-m}$,于是
$$
\tilde{\bm{q}}_m^\top \tilde{\bm{k}}_n
= \bm{q}^\top \bm{R}_m^\top \bm{R}_n \bm{k}
= \bm{q}^\top \bm{R}_{n-m} \bm{k}.
$$
这正是旋转位置编码(Rotary Position Embedding, RoPE) 的核心[^2]:内积仅依赖于相对位置 $n-m$,且编码以乘法形式施加在 $\bm{q},\bm{k}$ 上。
将内积展开,可得
$$
\tilde{\bm{q}}_m^\top \tilde{\bm{k}}_n
=\sum_{i=0}^{d/2-1} \big( q_{2i}k_{2i} + q_{2i+1}k_{2i+1} \big) \cos[(n-m)\theta_i]
+\big( q_{2i}k_{2i+1} - q_{2i+1}k_{2i} \big) \sin[(n-m)\theta_i].
$$
这可以看作原始内积被各个频率下的相对位置信号加权。若频率 $\theta_i$ 选取适当(例如 $\theta_i = 10000^{-2i/d}$,与正弦编码相同的衰减律),那么众多频率叠加的结果,随着相对距离 $|n-m|$ 增大,叠加信号会因相消干涉而逐渐衰减,最终趋近于零。这就是远程衰减在乘性编码中的实现机制。它不需要像加性编码那样对 $\bm{H}$ 施加硬性约束,而是通过高维频率的集体效应自然达成,因此鲁棒性远优于正弦位置编码。
3.3、RoPE的具体实现
不同配对方式,决定了 rotate_half(x) 的样子。
1 | RoPE(x) = x * cos(θ) + rotate_half(x) * sin(θ) |
原论文是拿相邻元素配对(如 ($x_0, x_1$)、($x_2, x_3$))来说明的。现在大多数开源实现都选择了首尾配对,而不是相邻元素两两配对。主要是工程实现太方便了,而且对模型效果几乎没有影响。
$$\begin{align}
\bm{x’} = \bm{x} \odot \cos + \begin{pmatrix} -x_{d/2} \ -x_{d/2+1} \ \vdots \ -x_{d-1} \ x_0 \ x_1 \ \vdots \ x_{d/2-1} \end{pmatrix} \odot \sin
\end{align}$$
首尾配对就是一行切片 + 拼接就完成了“旋转的另一半”,既不需要改变张量形状,也不引入额外的维度交换。这让代码更短,更容易读,也更不容易写错。
1 | torch.cat((-x[..., x.shape[-1] // 2:], x[..., :x.shape[-1] // 2]), dim=-1) |
相邻元素两两配对需要 reshape / stack 操作可能引入额外的内存重排,而 cat 在连续数据上开销极小。虽然差别不大,但在极度优化的大模型训练/推理中,少一次 reshape 终归是好事。
$$\begin{align}
\bm{x’} = \bm{x} \odot \bm{\cos} +
\begin{pmatrix}
-x_{1} \ x_{0} \
-x_{3} \ x_{2} \
\vdots \
-x_{d-1} \ x_{d-2}
\end{pmatrix}
\odot \boldsymbol{\sin}
\end{align}$$
1 | x = x.reshape(*x.shape[:-1], -1, 2) |
唯一的差别在于:哪个维度对共享一个旋转频率。
- 相邻配对:($x_0, x_1$) 用频率 $\theta_0$,($x_2, x_3$) 用 $\theta_1$,频率随索引单调变化。
- 首尾配对:($x_0, x_{d/2}$) 用 $\theta_0$,($x_1, x_{1+d/2}$)用 $\theta_1$,相当于把频率序列“交织”到了前后半上。
RoPE 前面的线性投影是完全可以学习的,网络完全可以自由地把重要特征放在它认为合适的维度上,去适配频率分配。实验上也反复验证过,两种配对的最终收敛效果没有显著差异。所以首尾配对就成了最好实现的那一种了。兼顾了代码清晰度、数学直观性和工程效率,并且在主流开源模型的带动下成了事实上的默认写法。
3.4、乘性位置编码评述
- RoPE 以乘法方式将相对位置信息注入 $\bm{q},\bm{k}$,严格实现了内积仅依赖相对位置,彻底消除了加性编码中一阶绝对位置项带来的困扰。
- 远程衰减由多频率叠加自然提供,无需对注意力权重矩阵作额外假设。
- 然而,RoPE 本身并不天然具备长度外推能力——当推理长度远超训练长度时,模型将遇到在训练中从未见过的极大相对位置 $n-m$,对应的旋转角度 $(n-m)\theta_i$ 进入未曾学习的区域,导致注意力分布混乱,性能急剧下降。这正是“长度外推”问题的核心挑战。
四、长度外推问题与方法
所谓长度外推(Length Extrapolation),就是让模型在推理时能处理好比训练序列更长的文本,而无需重新训练或仅需极少量微调。
对于使用 RoPE 的 LLM,长度外推的困难源于:训练窗口内的相对位置范围有限,比如最大长度为 $L$,模型只见过 $|n-m| \le L$ 的旋转角。当测试时输入长度 $L_{\text{test}} > L$,那些 $|n-m| > L$ 的相对位置对应的旋转角是“陌生”的,模型行为不可控。
针对这一问题,研究者们提出了多种外推方案,本质上都是在不改变模型结构的前提下,调整 RoPE 的旋转频率或位置索引,使得更大范围的相对位置被“压缩”或“映射”回模型熟悉的区间。下面分述其主要思路。
4.1、线性位置内插(Linear Position Interpolation)
最早被广泛采用的方法是由 Meta 等提出的位置内插(Position Interpolation, PI)。它将所有位置索引按比例缩小:
$$
m’ = m \cdot \frac{L}{L_{\text{test}}}, \qquad n’ = n \cdot \frac{L}{L_{\text{test}}},
$$
然后将 $\tilde{\bm{q}}_m = \bm{R}_{m’}\bm{q}$,$\tilde{\bm{k}}_n = \bm{R}_{n’}\bm{k}$。这样,任意测试序列中的相对位置 $n-m$ 都被压缩为 $(n-m) \cdot L/L_{\text{test}}$,落在 $[-(L-1), L-1]$ 的熟悉区间内。
优点:简单有效,只需少量微调(甚至不微调)即可将上下文窗口扩大数倍。
缺点:对所有频率一视同仁地压缩,导致高频细节信息(相邻 token 间的精细位置差异)被过分模糊,模型在短距离上的分辨能力受损;同时,极低频的成分也被过度压缩,未充分利用其潜力。
4.2、NTK‑Aware 缩放(基于神经正切核的频率内插)
线性位置内插(PI)将位置索引统一缩放,本质是对所有 RoPE 频率进行等比例压缩。记原始训练长度为 $L$,目标长度为 $L’$,缩放因子 $s = L’/L > 1$。PI 对位置做 $m’ = m/s$,等价于将每维频率 $\theta_i$ 直接替换为 $\theta_i/s$。这使得所有频率成分的波长 $\lambda_i = 2\pi/\theta_i$ 都拉伸 $s$ 倍,高频局部信息被过分模糊,导致短距离 token 的关系难以分辨。
NTK‑Aware 缩放的动机[^4]来自神经正切核(NTK)理论:在训练过程中,网络对不同频率成分的泛化能力存在差异——低频(长波长)容易通过内插扩展到未见过的更长距离,而高频(短波长)只应在极有限范围内变动,否则破坏已学到的局部模式。因此,更优的策略是对低频维度做大幅度拉伸,对高频维度几乎不动。
形式上,RoPE 的频率由基频 $b$(通常 $b=10000$)决定:
$$
\theta_i = b^{-2i/d}, \quad i = 0,1,\dots,\frac{d}{2}-1 .
$$
对应的波长为
$$
\lambda_i = \frac{2\pi}{\theta_i} = 2\pi\, b^{2i/d}.
$$
特别地,最大波长($i = d/2-1$)约为 $\lambda_{\max} \approx 2\pi\, b^{(d-2)/d}$。为让模型能处理长度为 $L’$ 的序列,该最大波长至少应与 $L’$ 相当,故设定 $\lambda’_{\max} \approx L’$。原始模型有 $\lambda_{\max} \approx L$。保持函数形式不变,只调整基频 $b$ 为 $b’$,则由
$$
\frac{\lambda’_{\max}}{\lambda_{\max}} = \frac{2\pi\,(b’)^{(d-2)/d}}{2\pi\, b^{(d-2)/d}} = \left(\frac{b’}{b}\right)^{(d-2)/d} = s
$$
解得
$$
\boxed{b’ = b \cdot s^{\frac{d}{d-2}}}.
$$
此即 NTK‑Aware 缩放的核心参数。相应地,新频率为 $\theta_i’ = (b’)^{-2i/d}$。
考察各维度的频率变化率:
$$
\frac{\theta_i’}{\theta_i} = \left(\frac{b’}{b}\right)^{-2i/d} = s^{-\frac{2i}{d-2}}.
$$
- 当 $i=0$(最高频,波长最短),$\theta_0’/\theta_0 = 1$,完全不变;
- 当 $i = d/2-1$(最低频,波长最长),$\theta_{d/2-1}’/\theta_{d/2-1} = s^{-1}$,频率缩小为原来的 $1/s$,波长拉伸 $s$ 倍。
波长拉伸比:
$$
\frac{\lambda_i’}{\lambda_i} = \frac{\theta_i}{\theta_i’} = s^{\frac{2i}{d-2}},
$$
随着 $i$ 增大,拉伸倍数平滑地从 $1$ 增加到 $s$。高频几乎保持原分辨率,低频被充分拉伸以覆盖新的长距离,从而在保留局部精细度和扩展长程依赖之间取得平衡。
与线性内插的比较:
- PI:对所有 $i$,$\lambda_i’/\lambda_i = s$,频率全部除以 $s$;
- NTK‑Aware:$\lambda_i’/\lambda_i = s^{2i/(d-2)}$,拉伸比随 $i$ 自适应变化。
实验表明,仅通过改变基频而无须微调,NTK‑Aware 缩放即可将上下文窗口扩大 2~4 倍,且困惑度上升缓慢。其背后的数学本质是:在频域内实现了非均匀的内插,高频保真、低频扩展,这恰与神经正切核下不同频率的收敛速率差异相契合。
4.3、YaRN(Yet another RoPE extensioN method)
YaRN[^3] 进一步将 NTK‑Aware 缩放与分段策略和温度校准统一起来,形成一套极高效率的长度外推框架,能够在极小量微调(甚至零微调)下实现百倍级别的上下文扩展。
4.3.1、分段频率缩放(“by parts” interpolation)
YaRN 观察到,不同波长的维度对外推的敏感度截然不同:
- 极高频(波长极短):相邻位置的相位变化已足够大,不需要任何拉伸,否则破坏局部关系;
- 极低频(波长极长):需要大幅拉伸以覆盖新长度,纯 NTK‑Aware 缩放较为合适;
- 中间频率:介于两者之间,宜采用线性混合。
为此,引入两个超参数 $\alpha, \beta$(通常取 $\alpha=1, \beta=32$ 或类似),定义波长的两个阈值:
$$
\lambda_{\text{low}} = \frac{2\pi}{\alpha}, \quad \lambda_{\text{high}} = \frac{2\pi}{\beta}.
$$
对每一维度 $i$ 的波长 $\lambda_i = 2\pi/\theta_i$,计算其目标缩放因子 $\gamma_i$:
$$
\gamma_i =
\begin{cases}
1, & \text{if } \lambda_i < \lambda_{\text{high}} \quad (\scriptsize\text{高频:不缩放}) \\
s, & \text{if } \lambda_i > \lambda_{\text{low}} \quad (\scriptsize\text{低频:全缩放}) \\
\scriptsize\text{线性插值}, & \text{otherwise}.
\end{cases}
$$
其中 $s = L’/L$。实际操作中,YaRN 并不直接缩放波长,而是等价地缩放旋转角度,即将位置索引 $m$ 变为 $m / \gamma_i$(或频率变为 $\theta_i / \gamma_i$)。这一策略记作 “NTK‑by‑parts”。数学上,可以写成统一的频率变换:
$$
\theta_i^{\text{YaRN}} = \frac{\theta_i}{\gamma_i},
\quad \scriptsize\text{其中 } \gamma_i = \big(1 - \text{ramp}(\lambda_i)\big) \cdot 1 + \text{ramp}(\lambda_i) \cdot s,
$$
$\text{ramp}(\lambda_i)$ 是一个在 $[\lambda_{\text{high}}, \lambda_{\text{low}}]$ 内从 0 线性增加到 1 的斜坡函数。这样,高频保持 $\gamma_i=1$,低频 $\gamma_i=s$,中间平滑过渡。
4.3.2、温度系数校准
长度外推不仅改变频率,也会改变注意力内积的统计特性。假设 $\bm{q}, \bm{k}$ 各分量独立同分布,训练时内积的方差为 $\sigma^2$。采用位置缩放后,相对位置被压缩,旋转角度变小,$\cos$ 项趋近于 1,导致内积的方差可能显著增大(或减小),使 softmax 的熵偏离训练时的稳态,产生极端的注意力分布,损害性能。
YaRN 通过引入一个长度温度 $t$ 来补偿这一变化。具体地,在 softmax 计算中将 logits 除以 $t\sqrt{d}$:
$$
a_{mn} = \text{softmax}!\left( \frac{\bm{q}_m^\top \bm{k}_n}{t \sqrt{d}} \right).
$$
直观上,当缩放因子 $s$ 较大时,内积的方差大致与 $s$ 正相关(因为有效频率降低,内积趋近于未旋转时的满幅度)。通过设定 $t$ 随 $s$ 增大而增大(通常取 $t = \sqrt{s}$),可以重新校准 softmax 的“温度”,使注意力分布保持合理的熵值,避免过于尖锐或平坦。在 YaRN 论文中,推荐的温度公式为
$$
\boxed{t = \sqrt{s}} ,
$$
或更精细的基于维度统计的校正。这一温度微调能够在不增加额外参数的情况下显著提升外推长度。
4.3.3、YaRN 整体算法
综上,YaRN 对 RoPE 的改造可总结为:
- 频率缩放:采用 NTK‑by‑parts 策略,得到每维新频率 $\theta_i’ = \theta_i / \gamma_i$,其中 $\gamma_i$ 由波长阈值和斜坡函数决定。
- 温度调节:在注意力计算中除以 $t \sqrt{d}$,$t = \sqrt{s}$。
完整的注意力分数计算为:
$$
\tilde{\bm{q}}_m = \bm{R}_{m}^{\text{YaRN}} \bm{q}, \quad
\tilde{\bm{k}}_n = \bm{R}_{n}^{\text{YaRN}} \bm{k}, \quad
a_{mn} = \text{softmax}!\left( \frac{\tilde{\bm{q}}_m^\top \tilde{\bm{k}}_n}{t \sqrt{d}} \right),
$$
其中 $\bm{R}_{m}^{\text{YaRN}}$ 是以 $\theta_i’$ 构造的旋转矩阵。
YaRN 的数学优势在于:同时处理了频域的非均匀插值(保持高频,拉伸低频)和概率空间的方差校准,两者协同使得模型在极长外推时仍能维持稳定的注意力模式。实验已证明,用 YaRN 只需对数千条长文本微调,即可将 Llama 系列的 2k 窗口稳定扩展至 128k 甚至 256k,是当前工业界最主流的长度外推方案之一。
4.4、其他方法简述
- ReRoPE:将位置索引进行分段处理,在局部窗口内保留完整高精度位置,在远处进行压缩,兼顾短距离精确性和长距离覆盖。
- ALiBi:在注意力分数上直接加一个与相对距离成比例的偏置,完全不使用位置嵌入,天然具有外推能力,但在表达能力上可能略逊于 RoPE。
- xPos:结合旋转编码与指数衰减,增强长度外推的稳定性。
从目前的工程实践来看,RoPE + NTK-Aware/YaRN 及其变体已成为大模型长度外推的主流方案,在 ChatGPT、Llama 2、Qwen 等众多模型中得到了验证。
五、极坐标位置嵌入(PoPE)
顺着前文乘性位置编码与长度外推的逻辑,对 PoPE [^5]进行完整的数学推导和介绍,着重说明它如何从 RoPE 的纠缠中解耦,以及为什么解耦能带来优异的长度外推能力。
在 3.2 节 中,我们推导出乘性位置编码的一般形式为 $\rho(\bm{q},m)=\bm{q}\,\mathrm{e}^{\mathrm{i}m\theta}$,即 RoPE。将键、询分别写成二维分量的复数形式后,RoPE 的注意力分数可表达为
$$\begin{align}
a_{ts}^{\text{RoPE}} = \sum_{c=1}^{d/2} \mu_{q_{tc}} \mu_{k_{sc}} \cos!\big((s-t)\theta_c + \phi_{k_{sc}} - \phi_{q_{tc}}\big), \tag{2}
\end{align}$$
其中 $\mu_{q_{tc}}, \phi_{q_{tc}}$ 是 $\bm{q}_t$ 的第 $c$ 个二维分量的极坐标(幅度与初相),$\mu_{k_{sc}}, \phi_{k_{sc}}$ 同理。交互项 $\phi_{k_{sc}}-\phi_{q_{tc}}$ 正是内容与位置纠缠的根源:它使得匹配不仅依赖于相对位置 $(s-t)$,还依赖于键、询内容的“方向”,导致模型难以独立地依据内容或位置进行推理。
5.1、PoPE 的构造与动机
PoPE 的核心思想是:将每个特征维度独立地变为一个复数,其幅度只由内容决定,相位只由绝对位置决定,从而彻底消除交互项。
设第 $t$ 个位置的查询向量为 $\bm{q}_t \in \mathbb{R}^d$,第 $s$ 个位置的键向量为 $\bm{k}_s \in \mathbb{R}^d$($d$ 为任意正整数,无需偶数)。对每一个分量 $c=1,\dots,d$,我们构造复数形式的查询和键:
- 幅度:$\mu_{\tilde{q}_{tc}} = \sigma(q_{tc})$,$\mu_{\tilde{k}_{sc}} = \sigma(k_{sc})$,其中 $\sigma(x)=\ln(1+e^x)$ 是 softplus 函数。它保证幅度非负,且数值稳定,近似于 ReLU 但处处可微。
- 相位:$\phi_{\tilde{q}_{tc}} = t\theta_c$,$\phi_{\tilde{k}_{sc}} = s\theta_c$,其中 $\theta_c = \theta^{(c-1)/d}$,基频 $\theta$ 通常取 $10000$(与 RoPE 类似,但这里 $c$ 从 $1$ 到 $d$,频率跨度比 RoPE 更宽)。
于是复数查询和键分别为:
$$
\tilde{q}_{tc} = \mu_{\tilde{q}_{tc}} \mathrm{e}^{\mathrm{i}\,t\theta_c}, \qquad
\tilde{k}_{sc} = \mu_{\tilde{k}_{sc}} \mathrm{e}^{\mathrm{i}\,s\theta_c}.
$$
进一步,我们为每个分量引入一个可学习的相位偏置 $\delta_c \in [-2\pi,0]$,只加在键侧(或查询侧,对称无本质区别),得到最终的键表示:
$$
\tilde{k}_{sc} = \mu_{\tilde{k}_{sc}} \mathrm{e}^{\mathrm{i}(s\theta_c + \delta_c)}.
$$
$\delta_c$ 的作用是让模型能够学习最优的相对相位偏移,部分弥补去掉交互项后可能损失的灵活性。
5.2、注意力分数的推导
根据引理 1(两个二维实向量的内积等于对应复数的乘积的实部),推广到高维,PoPE 的注意力分数定义为复数内积的实部:
$$\begin{align}
a_{ts}^{\text{PoPE}}
&= \Re!\left[ \tilde{\bm{q}}_t^H \tilde{\bm{k}}_s \right]
= \Re!\left[ \sum_{c=1}^{d} \tilde{q}_{tc}^* \, \tilde{k}_{sc} \right] \\
&= \Re!\left[ \sum_{c=1}^{d} \mu_{\tilde{q}_{tc}} \mathrm{e}^{-\mathrm{i}\,t\theta_c} \cdot \mu_{\tilde{k}_{sc}} \mathrm{e}^{\mathrm{i}(s\theta_c + \delta_c)} \right] \\
&= \sum_{c=1}^{d} \mu_{\tilde{q}_{tc}} \mu_{\tilde{k}_{sc}} \, \Re!\left[ \mathrm{e}^{\mathrm{i}[(s-t)\theta_c + \delta_c]} \right] \\
&= \sum_{c=1}^{d} \sigma(q_{tc}) \, \sigma(k_{sc}) \, \cos!\big((s-t)\theta_c + \delta_c\big)
\end{align}$$
与 RoPE 对比,区别一目了然:
- RoPE:$\cos$ 的相位包含 $\phi_{k_{sc}}-\phi_{q_{tc}}$,内容与位置耦合。
- PoPE:$\cos$ 的相位仅由相对位置 $(s-t)$ 和固定的可学习偏置 $\delta_c$ 决定,幅度 $\sigma(q_{tc}),\sigma(k_{sc})$ 只编码内容的强度,不干预相位。
这正是 “是什么(what)”与“在哪里(where)”的完全解耦。
5.3、性质验证
回到我们在 2.1 节 提出的三个理想性质:非对称性、远程衰减、平移不变。
- 平移不变性:$a_{ts}^{\text{PoPE}}$ 仅依赖于相对位置 $(s-t)$,故严格满足。
- 非对称性:虽然单对键询的匹配分数对称($a_{ts}=a_{st}$ 当其他所有 token 都相同?实际上这里 $a_{ts}$ 本身对于交换 $t,s$ 是对称的,因为 $\cos$ 是偶函数),但最终注意力权重由 softmax 对所有 $s$ 归一化得到,整体模式仍是非对称的——查询“我”对键“爱”的注意力,与查询“爱”对键“我”的注意力,由于上下文其他键不同,概率分布不同。这与 RoPE 的机制一致,故非对称性保持。
- 远程衰减:将 $a_{ts}^{\text{PoPE}}$ 视为相对距离 $\Delta = s-t$ 的函数。由于频率 $\theta_c$ 从 $\theta^0$ 到 $\theta^{(d-1)/d}$ 覆盖了多个尺度,当 $d$ 较大时,$\sum_c \cos(\Delta\theta_c + \delta_c)$ 会因相消干涉而随着 $|\Delta|$ 增大呈现衰减趋势(类似狄利克雷核)。若 $\delta_c=0$,衰减速度取决于频率分布;引入 $\delta_c$ 后可调整衰减包络。PoPE 有效利用了高频分量,使得短距离保持高分辨率,同时低频分量提供了长程覆盖,整体呈现良好的远程衰减。
5.4、解耦如何带来强大的长度外推能力
长度外推的难点在于:测试时出现训练未见的相对位置 $|\Delta| > L$,此时 RoPE 的 $\cos[(s-t)\theta_c + \phi_{k}-\phi_{q}]$ 中,内容决定的相位偏移 $\phi_{k}-\phi_{q}$ 会进一步放大未知性——模型不仅要处理陌生的纯位置角度,还要处理陌生角度与内容相位的组合,行为极易失控。在 PoPE 中,注意力分数为 $\sum_c \sigma(q_{tc})\sigma(k_{sc}) \cos(\Delta\theta_c + \delta_c)$,其中 $\Delta$ 为测试时的新相对距离。这里有两个关键性质:
- 相位纯粹是位置的函数,与内容无关。因此,模型在训练中学习到的映射 $f(\Delta) = \cos(\Delta\theta_c+\delta_c)$ 是一个定义在 $\mathbb{R}$ 上的平滑周期函数。即使 $\Delta$ 超出训练范围,$\cos$ 函数仍然有界、平滑,且其周期性意味着极长的 $\Delta$ 对应着将已知角度“折叠”回来,不会出现指数级爆炸或畸变。
- 低频分量主导长程行为。对于最小的频率 $\theta_{\max} = \theta^{(d-1)/d} \approx \theta$(当 $d$ 大时),对应的波长 $\lambda_{\max} = 2\pi/\theta_{\max} \approx 2\pi/\theta$。在标准设置 $\theta=10000$ 时,$\lambda_{\max} \approx 6283$,远大于常规训练长度 2048。因此,即使外推到数万 token,这个最低频分量也仅经历了不到一个完整周期,其 $\cos$ 值仍处于训练时见过的函数曲线上,没有进入完全陌生的区域。相比之下,RoPE 的内容相位可能使低频分量的等效相位偏移,使其提前进入未学习区间。
因此,PoPE 天生具备零样本长度外推能力,无需像 YaRN 那样对频率进行插值或微调。论文中的实验证实:在 PG-19 上将训练长度 1024 外推 10 倍到 10240,PoPE 的困惑度保持平稳,而 RoPE 急剧上升,甚至超过专门微调的 YaRN。
若对 PoPE 进行极少量长文本微调(PoPE+ft),低频分量的 $\delta_c$ 或幅度利用模式可进一步适应长程依赖,性能继续提升,这从原论文中关于 PoPE+ft 图曲线最低可以看出。
5.5、与 RoPE 及 YaRN 的数学关系
- RoPE → PoPE:若将 RoPE 的每个二维分量强行拆成两个独立的一维分量,并令每个分量的幅度为内容值的绝对值或 softplus,相位仅为位置频率,则退化到 PoPE 的无偏置形式。区别在于 RoPE 用两个实数的组合表示一个复数,幅度和相位都来自内容;而 PoPE 显式分离两者。
- YaRN 的频率内插 是为了“压缩”相对位置,使大 $\Delta$ 映射到训练区间。PoPE 则不需要这种映射,因为其相位函数 $\cos(\Delta\theta_c+\delta_c)$ 本身对 $\Delta$ 是全局良定义的。从 NTK 角度看,PoPE 相当于让所有频率分量保持原始波长,但内容不再干扰相位,因此低频分量天然具有极长的“初始波长”,能够覆盖外推范围,而不必进行频率缩放。
个人评述:PoPE 从数学上通过“一个特征一个复数”的极坐标表示,将 RoPE 中纠缠的内容相位剥离,实现了 内容幅度 × 位置相位 的彻底解耦。这一简洁的修改在保持相对位置编码所有优点的同时,赋予了模型极为出色的零样本长度外推特性,并在多个领域和规模下验证了其优越性。这为未来摆脱繁琐的频率插值、实现原生长上下文 Transformer 提供了新的理论基础。
5.6、PoPE的问题
5.6.1、PoPE必须加 softplus 激活
要使用PoPE,必须引入极坐标,需要对 k,v 加 softplus 激活,让模长为非负。在 RoPE 中,Q 和 K 的点积展开是:
$$\begin{align}
q \cdot k = |q||k| \cos(\theta_q - \theta_k + m\Delta\theta)
\end{align}$$
注意看 $\theta_q - \theta_k$ 这一项。在 RoPE 里,内容(词向量)不仅决定了模长 $|q|, |k|$,还决定了初始相位 $\theta_q, \theta_k$。这意味着模型可以学习让两个意思相近的词,不仅模长大,而且初始相位也接近,从而在距离较远时依然能产生较高的注意力分数。
而在 PoPE 中,因为强制进入了极坐标,且加了 softplus:
$$\mu_q = \text{softplus}(q), \quad \mu_k = \text{softplus}(k) $$
点积变成了:
$$\mu_q \mu_k \cos(m\Delta\theta + \delta) $$
这里 $\theta_q$ 和 $\theta_k$ 被彻底剥离了! 内容只能去控制模长 $\mu$(而且被 softplus 压缩到了非负数),再也无法影响初始相位了。 所以模型失去了“用初始相位来编码内容相似度”的能力。 而且 softplus 把 $(-\infty, +\infty)$ 压缩到 $(0, +\infty)$,相比 RoPE 不做处理的线性投影,确实也是一种信息压缩。
那我不加 softplus,直接让模长 $r$ 可以为负不行吗?不行,因为负的模长会破坏“解耦”。
在极坐标下,如果 $r < 0$,数学上等价于 $|r| e^{i(\theta + \pi)}$。也就是说,如果你允许内容(Q/K值)通过正负号来影响模长,正负号的翻转实际上就是偷偷给相位加了 180度 $(\pi)$ 的偏移!
这会导致内容信息再次“污染”相位,PoPE 苦心经营的“位置只管相位,内容只管模长”的解耦就彻底破产了。所以,softplus(或任何非负映射)是维持极坐标解耦的物理底线。 代价就是牺牲了负半轴的表达力,同时增加了计算量。
5.6.2、既然损失了表达力,为什么 PoPE 还比 RoPE 好?
这就是核心问题。答案在于 RoPE 的一个致命缺陷:注意力稀释。在 RoPE 中,因为内容耦合在相位里,当相对距离 $m$ 变大时,$\cos(\theta_q - \theta_k + m\Delta\theta)$ 的抖动是不可控的。对于长文本,RoPE 的注意力分数会随着距离增加而迅速衰减或剧烈震荡,导致模型“看不清”远处的 token。PoPE 的作者发现了一个极其关键的规律:在自然语言中,内容的相关性(语义)不应该随距离发生剧烈的周期性震荡,只有位置的权重应该随距离衰减。 因此,PoPE 做了一个极其粗暴但有效的假设:
内容的相似度,只看模长(大小)就够了,不需要看相位!
- 1、牺牲的: 词与词之间那种微妙的“初始相位契合度”。
- 2、换来的: 绝对干净的位置衰减曲线 $\cos(m\Delta\theta)$。
在 PoPE 中,不管两个词的内容是什么($\mu_q, \mu_k$ 有多大),它们受距离影响的衰减规律是完全一致的。这让模型在超长上下文中的行为变得极其稳定可预测,从而获得了 RoPE 难以企及的长度外推能力。
5.6.3. 模型真的在乎丢失的那点表达力吗?
其实不太在乎。Transformer 的隐藏层维度极高(比如 4096 维)。在如此高维的空间里,仅仅靠各个维度的幅值大小(非负),已经足够表达复杂的语义相似度了。打个比方:你要比较两个人的相似度(注意力)。
- RoPE 的做法: 既看两人的身高体重(模长),又看两人面朝哪个方向站(初始相位),还要根据两人站位的距离排兵布阵。
- PoPE 的做法: 强制所有人必须面朝正前方站(初始相位强制为 0 / 剥离),只比较身高体重(softplus后的模长),然后单纯根据距离来分配注意力。
PoPE 的做法看起来简单粗暴,丧失了“面朝不同方向”的微操能力,但在成千上万人的大广场(长文本)上,RoPE 那种“方向+距离”纠缠在一起的排兵布阵会彻底乱套,而 PoPE 却能井然有序。
六、总结与体会
回望位置编码的演进,从正弦加性编码到旋转乘性编码,核心驱动力始终是对“相对位置”的优雅表达。RoPE 以其数学上的简洁和对相对位置的完美捕捉,统一了加性编码所追求的诸多性质,为 Transformer 的长序列建模奠定了坚实基础。
然而,RoPE 的长度外推困境暴露了一个深层问题:查询和键的内容信息与位置信息被纠缠在同一个复数相位中。陌生的大旋转角叠加了内容带来的相位偏移,使模型在长序列上面对高度 OOD 的输入。NTK‑Aware、YaRN 等方法试图通过插值或缩放频率将这种 OOD“拉回”训练分布,但本质上是对信息的压缩,且往往需要微调,外推能力仍然受限于插值策略。
PoPE 的出现提供了另一种思路:它通过极坐标表示,将每个特征维度独立地映射为复数,令幅度仅编码内容强度、相位仅由绝对位置决定,从而彻底移除了 RoPE 中的交互项 $\phi_k - \phi_q$。这一简洁的修改,在数学上实现了“是什么”与“在哪里”的完全解耦。推导表明,PoPE 的注意力分数只依赖于相对位置和可学习的固定偏置,其相位函数是整个实数域上的平滑周期函数,低频分量天然具有覆盖极长距离的能力。因此,PoPE 无需任何频率内插或微调,即可实现显著的零样本长度外推,在 10 倍训练长度的测试中保持稳定,甚至优于专门为外推设计的微调方法。
这给我们的启示是:长度外推的障碍并不全在于相对位置编码本身,而很大程度源于内容对位置调谐的干扰。一旦将二者解耦,相对位置编码可以同时兼备局部分辨与长程覆盖,不必再以“压缩信息”为代价换取外推。PoPE 在间接索引、音乐、基因组和语言建模上的全面提升,也印证了解耦带来的归纳偏置更贴合序列中“内容匹配”与“位置匹配”相互独立的真实结构。
个人的体会是:真正根本性的长度外推,未必需要完全抛弃位置编码或转向全新的注意力机制。在已有框架内厘清“是什么”与“在哪里”的职责边界,就能释放出惊人的泛化能力。当然,PoPE 还只是一个开始——如何将这种解耦思想与线性注意力、状态空间模型等更高效的架构结合,如何在更复杂的多模态序列中定义位置与内容的独立表达,仍是值得探索的方向。或许,让长度不再是序列模型的“硬约束”,正需要从这种回归本质的解耦开始。
本文梳理至此,疏漏难免,恳请读者批评指正。
参考文献
[^1]: Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., et al. (2023, August 2). Attention is all you need. arXiv. https://doi.org/10.48550/arXiv.1706.03762
[^2]: Su, J., Ahmed, M., Lu, Y., Pan, S., Bo, W., & Liu, Y. (2024). RoFormer: enhanced transformer with rotary position embedding. Neurocomputing, 568, 127063. https://doi.org/10.1016/j.neucom.2023.127063
[^3]: Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2026, February 6). YaRN: efficient context window extension of large language models. arXiv. https://doi.org/10.48550/arXiv.2309.00071
[^4]: bloc97. NTK-Aware Scaled RoPE allows LLaMA models to have extended (8k+) context size without any fine-tuning and minimal perplexity degradation., 2023a. URL https://www.reddit.com/r/LocalLLaMA/comments/14lz7j5/ntkaware_ scaled_rope_allows_llama_models_to_have/
[^5]: Gopalakrishnan, A., Csordás, R., Schmidhuber, J., & Mozer, M. C. (2025). Decoupling the “what” and “where” with polar coordinate positional embeddings. arXiv. https://doi.org/10.48550/ARXIV.2509.10534
| 版权声明 |  |
 | 由引线小白创作并维护的柠檬CC博客采用署名-非商业-禁止演绎4.0国际许可证。 本文首发于柠檬CC [ https://www.limoncc.com ] , 版权所有、侵权必究。 |
| 本文永久链接 | https://www.limoncc.com/post/027d78612e329155/ |
| 如果您需要引用本文,请参考: |
| 引线小白. (Sep. 27, 2023). 《大语言模型研究13——长度外推》[Blog post]. Retrieved from https://www.limoncc.com/post/027d78612e329155 |
| @online{limoncc-027d78612e329155, title={大语言模型研究13——长度外推}, author={引线小白}, year={2023}, month={Sep}, date={27}, url={\url{https://www.limoncc.com/post/027d78612e329155}}, } |